AI-Readyとは?
企業が生成AIを活用するために必要なデータ整備の条件
近年、多くの企業がChatGPTをはじめとする生成AIや、社内データを参照させるRAG(検索拡張生成)の導入を進めています。しかし、いざ実業務に適用しようとすると、「期待したような精度の高い回答が出ない」「社内特有のルールや最新の数値を全く反映してくれない」という壁に直面するケースが後を絶ちません。
この失敗の根本的な原因は、AI(LLM)自体の性能不足にあるのではありません。社内のデータが、AIにとって「読み取れる状態」になっていないことが最大のボトルネックなのです。
生成AIのポテンシャルを最大限に引き出すためには、データ基盤を「AI-Ready(エーアイ・レディ)」な状態に整えることが不可欠です。本コラムでは、AI-Readyの真の意味と、生成AI活用を成功に導くためのデータ構造化プロセスについて解説します。
「AI-Ready」とは何か?
AI-Readyとは、社内に蓄積されたデータが「人間の手による前処理(データクレンジングやフォーマット変換)を必要とせず、AIがそのまま読み込み、解釈・学習できる状態」に整備されていることを指します。
ここで重要になるのが、「人間のためのデータ」と「AIのためのデータ」の違いを理解することです。
- Not AI-Ready(非構造化データ):見た目を重視して罫線やセル結合を多用した帳票、手書きメモをスキャンしただけのPDF、担当者ごとに書き方が異なるテキストファイルなど。人間が見れば文脈で理解できても、AIにとってはどこからどこまでがひとつの意味のまとまりなのか判別できず、構造が破綻しています。
- AI-Ready(構造化データ):列と行の意味が明確に定義され、表記揺れがなく、関連する属性情報(メタデータ)が付与されているデータ。システムやAIが機械的に処理できる状態を指します。
AIに正しく社内のナレッジを理解させるには、後者の「構造化データ」をいかに継続して蓄積できるかが鍵となります。
企業が生成AIを活用するために必要な3つの条件
AIが正しく機能するデータ基盤を作るためには、以下の3つの条件をクリアする必要があります。
条件1:フォーマットの統一と表記揺れの排除
例えば、顧客名に「株式会社」「(株)」「カブシキガイシャ」が混在していたり、日付が「2026/12/1」「令和8年12月1日」とバラバラに入力されていたりすると、AIはそれらを同一のものとして正確に紐付けることが難しくなります。入力段階での適切なデータ統制(バリデーション機能)が必須です。
条件2:アクセス権限とセキュリティ要件の整理(ガバナンス)
全社のファイルサーバを丸ごとAIに読み込ませるのは非常に危険です。機密情報や個人情報、経営層のみが閲覧できる人事評価データなどが混在していると、プロンプト次第でAIがそれらの情報を一般社員に回答してしまうリスク(情報漏洩)があります。「どの範囲のデータをAIに参照させるか」を制御できる権限管理の仕組みが求められます。
条件3:リアルタイム性とデータ連携パイプライン
AIに学習させたデータが半年前のものであれば、出力される回答も陳腐化します。業務プロセスの中で自然と最新のデータが蓄積され、WebAPIやWebhookを通じてリアルタイムかつシームレスにAIシステム(RAG等)へ連携できるエコシステムが必要です。
Excelのみの運用が「AI-Ready化」を阻む最大の要因
多くの企業で業務効率化の主役として活躍してきた表計算ソフト(Excel等)ですが、こと「AI活用」の文脈においては最大のボトルネックになりえます。
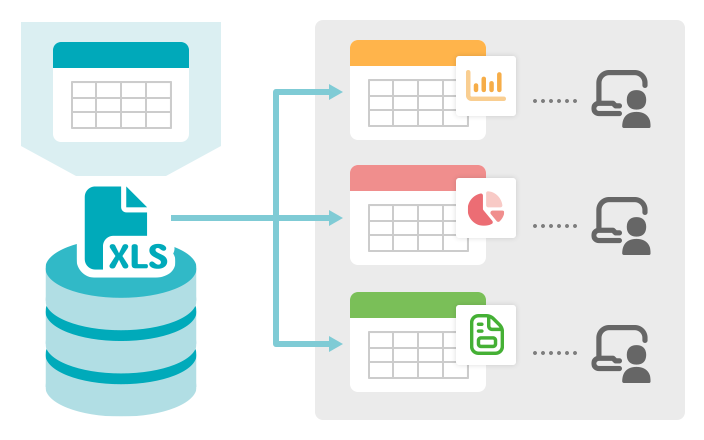
個人のPCや部署ごとの共有フォルダにファイルが散在する「サイロ化」が起きやすく、「どれが最新の正解データなのか」が誰にも分かりません。さらに、印刷時の見栄えを重視した「神Excel」や、セル内に複数の要素(日付と担当者名など)を混在させる入力方式は、そのままではAIの学習データとして全く使い物になりません。
既存のExcelファイルを後からAI向けにクレンジング(手作業での修正やマクロによる変換)するのは、膨大なコストと時間がかかり、現実的な解決策とは言えません。
現場主導の「市民開発」がAI-Readyな状態を維持する鍵
全社のあらゆる業務データを、情報システム部門が中央集権的にクレンジングし、構造化し続けるのは不可能です。最も確実かつ持続可能な方法は、「現場がデータを入力する瞬間に、自動的に構造化される仕組み」を作ることです。
ここで重要になるのが、現場部門自らが業務アプリを構築する「市民開発」のアプローチです。
業務のルール、必要なデータ項目、入力の際のつまづきポイントを最も深く理解しているのは、実際に業務を行う現場の担当者です。プログラミング知識がなくても直感的に操作できる「完全ノーコード」のWebデータベースを導入し、現場主導でドロップダウンリストや必須チェックを備えた入力フォームを作成させるのです。
現場のメンバーが自分たちの業務を楽にするためにアプリを作り、日々そこへ入力を行う。その結果として、裏側にはガバナンスの効いた「AI-Readyな構造化データ」が自然と蓄積されていく。この一連のサイクルを生み出す環境作りこそが、次世代のリーダーや管理職に求められるDX戦略の要となります。
「市民開発」について、より詳しい説明は下記のページをご覧ください。
生成AI時代のデータ基盤構築に向けて
生成AIの導入を成功させる近道は、高価なAIツールを比較検討することではなく、まず足元のデータを「AIが活用できる形」に整えることです。Excel単体の運用からExcelの情報をデータベース管理できる運用へと進化させ、ノーコードツールを部門のDX基盤として定着させることが、全社的なAI活用の最短ルートとなります。
「楽々Webデータベース」は、現場の担当者が完全ノーコードで簡単に業務アプリを作成できる市民開発プラットフォームです。
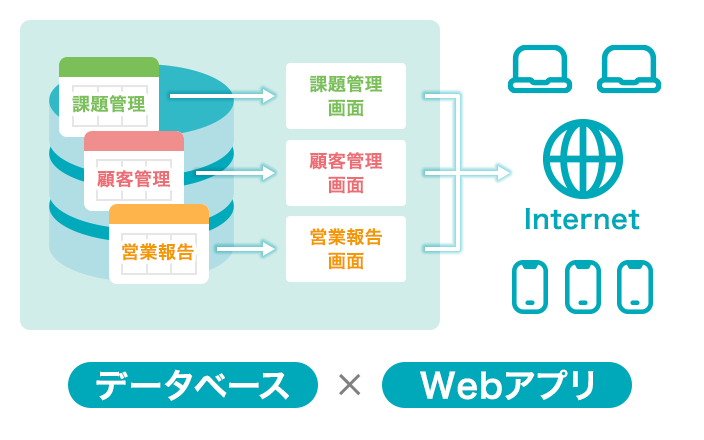
Excelを取り込むだけでWebアプリ化でき、入力時のフォーマット統一を実現します。また、AI-OCRによるデータ取り込みにも対応し、PDFやExcelファイルなどからデータを自動読み取り、登録が可能です。
さらに、強力なアクセス権限管理と、外部システムとの連携を容易にするWebAPI / Webhook・外部DB直接参照機能を備えており、セキュアで最新の「AI-Ready」なデータ基盤を即座に構築することが可能です。
| 段階 | 従来の課題 (Not AI-Ready) |
楽々Webデータベース導入後 (AI-Ready) |
|---|---|---|
| データ入力・収集 | 表記の揺れ、フォーマット不統一、Excelファイルが乱立し、原本特定が困難 | ノーコードで入力フォーム・制約(型・バリデーション)を統一。正しく正規化されたデータの蓄積が可能 |
| データ取り込み | 紙の帳票やPDF、FAXなど、手入力や非構造化データが多く、構造化データへの変換・蓄積に手間がかかる | 紙・PDFなどの非構造化データをAI-OCRで自動読み込みし、スピーディーに構造化データとして自動登録 |
| データ管理 | 個人PCや共有フォルダにファイルが孤立(データのサイロ化) | ガバナンスの効いたWebデータベース上で一元管理。権限管理・履歴も保持 |
| AI活用・連携 | 散在・未整理のためAIに読み込ませられず、前処理に多大なコストがかかる | WebAPI / Webhook連携により、蓄積された構造化データを生成AIやRAG、社内AIツールへ即座に出力・参照可能 |
自社のデータ活用や生成AI導入に課題を感じている方は、現場に負担をかけずに正しいデータが蓄積されていく「楽々Webデータベース」の活用をぜひご検討ください。
社内に眠るデータの真価を引き出し、次なるビジネス成長への足がかりとなるはずです。
まずは無料でお試ししませんか?
執筆者:牛島 猛
住友電工情報システム株式会社
ビジネスソリューション事業本部 第一システム開発部
東京フレームワーク コンサルティンググループ グループ長
楽々Framework3・楽々Webデータベース・楽々WorkflowII を中心に、
お客さまの業務改革や効率的なデータ活用の支援・提案を実施中。